Archive

Articles taggués ‘iptables’

Easy Ubuntu 16.04 Server Firewall

08/12/2023 Comments off

If you read our previous article Easy Ubuntu Server Firewall, then you may have noted that on Ubuntu 16.04 the described method no longer works. This is due to systemd. In the article below we will walk through creating a persistent IPTables based firewall on Ubuntu 16.04 LTS. First we need to install some required software packages. As seen in the command below, install iptables-persistent. Next we will make netfilter-persistent run at boot. This is the most important step as it will ensure your rules are reloaded at boot time.

# Install IPTables Persistent Package
apt-get install -y iptables-persistent
# Add netfilter-persistent Startup
invoke-rc.d netfilter-persistent save
# Stop netfilter-persistent Service
service netfilter-persistent stop

Once the packages above are installed and the service is stopped, you will have a new directory at /etc/iptables/. This directory holds the IPTables filter rules that will be reloaded at boot time. These files are named rules.v4 and rules.v6 respectively. IPV4 rules are loaded into rules.v4 and IPV6 rules are loaded into rules.v6. For the purpose of this article we will focus on IPV4 rules. Next we will want to copy the rules below into our rules.v4 file. Of course the rules will need to be modified to fit your environment.

# Generated by iptables-save v1.3.3 on Wed Apr 9 10:51:08 2008
# Flush out any rules that are already in there
*filter
:INPUT ACCEPT [146:11332]
:FORWARD ACCEPT [0:0]
:OUTPUT ACCEPT [104:9831]
 
# Allow internal loopback connections
-A INPUT -i lo -j ACCEPT
-A OUTPUT -o lo -j ACCEPT
 
# Allow pinging
-A INPUT -p icmp -m icmp --icmp-type 8 -j ACCEPT
 
# Allow any outbound data, and any inbound data related to a connection that is already in use
-A INPUT -m state --state RELATED,ESTABLISHED -j ACCEPT
-A OUTPUT -m state --state NEW,RELATED,ESTABLISHED -j ACCEPT
 
# =========BEGIN SERVER SPECIFIC PORT OPEN RULES=========
# Allow SCP/SSH Access from Green & Blue Subnet
-A INPUT -s 172.16.12.0/255.255.255.0 -p tcp -m tcp --dport 22 -j ACCEPT
-A INPUT -s 10.10.12.0/255.255.255.0 -p tcp -m tcp --dport 22 -j ACCEPT
 
# Allow HTTP Access from Red Subnet/Internet
-A INPUT -p tcp -m state --state NEW,ESTABLISHED --dport 80 -j ACCEPT
 
# Allow HTTPS Access from Red Subnet/Internet
-A INPUT -p tcp -m state --state NEW,ESTABLISHED --dport 443 -j ACCEPT
 
# Allow MySQL Access from Red Subnet/Internet
-A INPUT -p tcp -m state --state NEW,ESTABLISHED --dport 3306 -j ACCEPT
 
# Allow FTP Access from Red Subnet/Internet
-A INPUT -p tcp -m state --state NEW,ESTABLISHED --dport 21 -j ACCEPT
-A INPUT -p tcp -m state --state NEW,ESTABLISHED --dport 58000:58010 -j ACCEPT
# =========END SERVER SPECIFIC PORT OPEN RULES=========
 
# Drop everything that hasn't been picked up by one of the rules above
-A INPUT -j DROP
-A FORWARD -j DROP
-A OUTPUT -j DROP
 
COMMIT
# Completed on Wed Apr 9 10:51:08 2008

Lastly, in order for our new rules to take affect, we simply need to start the netfilter-persistent service as seen below. That’s it, you now have a fully functional IPTables based firewall.

# Start netfilter-persistent Service
service netfilter-persistent start

# Check if IPTables were applied
iptables -L
Rendre ses règles persistantes sous GNU/Debian avec iptable-persistent

27/11/2023 Comments off

Si vous souhaitez rendre vos règles de firewalling persistantes les développeurs de iptables ont prévu deux commandes : iptables-save et iptables-restore.

Ces commandes permettent de créer une copie de la configuration actuelle et de charger une de ces copies.

Il se trouve que nos amis de chez Debian ont prévu un petit script permettant d’automatiser le chargement des règles iptables au démarrage : iptables-persistent. Nous allons donc dans un premier temps installer ce paquet. Nous verrons ensuite comment sauvegarder notre configuration actuelle.

Installation de iptables-persistent

L’installation est très très très simple … voyez plutôt !

# aptitude install iptables-persistent 

Et le tour est joué !

À l’installation il vous sera demandé si vous souhaitez sauvegarder les règles de firewalling actuellement en place. Vous pouvez répondre oui ou non.

Ce paquet vous a créé plusieurs fichiers dont

  • /etc/iptables/rules.v4 : Le fichier qui sera lu par le script de démarrage pour charger vos règles IPV4.
  • /etc/iptables/rules.v6 : Le fichier qui sera lu par le script de démarrage pour charger vos règles IPV6.

Sauvegarder nos règles

Comme je le disais plus haut, il existe la commande iptables-save qui nous permet d’exporter la configuration actuelle. Petit exemple

# iptables-save

<em id="__mceDel"># Generated by iptables-save v1.4.8 on Thu Apr 18 20:48:47 2013
*raw
:PREROUTING ACCEPT [9797384:2383152683]
:OUTPUT ACCEPT [7848850:7602037790]
COMMIT
# Completed on Thu Apr 18 20:48:47 2013
# Generated by iptables-save v1.4.8 on Thu Apr 18 20:48:47 2013
*nat
:PREROUTING ACCEPT [535202:35374631]
:INPUT ACCEPT [535202:35374631]
:OUTPUT ACCEPT [107902:12861811]
:POSTROUTING ACCEPT [107902:12861811]
COMMIT
# Completed on Thu Apr 18 20:48:47 2013
# Generated by iptables-save v1.4.8 on Thu Apr 18 20:48:47 2013
*mangle
:PREROUTING ACCEPT [9797384:2383152683]
:INPUT ACCEPT [9797384:2383152683]
:FORWARD ACCEPT [0:0]
:OUTPUT ACCEPT [7848852:7602038246]
:POSTROUTING ACCEPT [7848852:7602038246]
COMMIT
# Completed on Thu Apr 18 20:48:47 2013
# Generated by iptables-save v1.4.8 on Thu Apr 18 20:48:47 2013
*filter
:INPUT ACCEPT [721005:567300541]
:FORWARD ACCEPT [0:0]
:OUTPUT ACCEPT [7247423:5928062896]
-A INPUT -p tcp -m tcp --dport 22 -j ACCEPT
-A INPUT -p tcp -m tcp --dport 80 -j ACCEPT
COMMIT
# Completed on Thu Apr 18 20:48:47 2013

La seul chose que nous avons à faire est de rediriger la sortie de cette commande non plus dans le terminal mais dans le fichier rules.v4 ou rules.v6 utilisés par iptables-persistent.

# iptables-save > /etc/iptables/rules.v4
 # iptables-save > /etc/iptables/rules.v6
Categories: Réseau, Sécurité Tags: ,

A Deep Dive into Iptables and Netfilter Architecture

26/11/2023 Comments off

Introduction

Firewalls are an important tool that can be configured to protect your servers and infrastructure. In the Linux ecosystem, iptables is a widely used firewall tool that interfaces with the kernel’s netfilter packet filtering framework. For users and administrators who don’t understand the architecture of these systems, creating reliable firewall policies can be daunting, not only due to challenging syntax, but also because of number of interrelated parts present in the framework.

In this guide, we will dive into the iptables architecture with the aim of making it more comprehensible for users who need to build their own firewall policies. We will discuss how iptables interacts with netfilter and how the various components fit together to provide a comprehensive filtering and mangling system.


What Are IPTables and Netfilter?

The basic firewall software most commonly used in Linux is called iptables. The iptables firewall works by interacting with the packet filtering hooks in the Linux kernel’s networking stack. These kernel hooks are known as the netfilter framework.

Every packet that enters networking system (incoming or outgoing) will trigger these hooks as it progresses through the stack, allowing programs that register with these hooks to interact with the traffic at key points. The kernel modules associated with iptables register at these hooks in order to ensure that the traffic conforms to the conditions laid out by the firewall rules.


Netfilter Hooks

There are five netfilter hooks that programs can register with. As packets progress through the stack, they will trigger the kernel modules that have registered with these hooks. The hooks that a packet will trigger depends on whether the packet is incoming or outgoing, the packet’s destination, and whether the packet was dropped or rejected at a previous point.

The following hooks represent various well-defined points in the networking stack:

  • NF_IP_PRE_ROUTING: This hook will be triggered by any incoming traffic very soon after entering the network stack. This hook is processed before any routing decisions have been made regarding where to send the packet.
  • NF_IP_LOCAL_IN: This hook is triggered after an incoming packet has been routed if the packet is destined for the local system.
  • NF_IP_FORWARD: This hook is triggered after an incoming packet has been routed if the packet is to be forwarded to another host.
  • NF_IP_LOCAL_OUT: This hook is triggered by any locally created outbound traffic as soon it hits the network stack.
  • NF_IP_POST_ROUTING: This hook is triggered by any outgoing or forwarded traffic after routing has taken place and just before being put out on the wire.

Kernel modules that wish to register at these hooks must provide a priority number to help determine the order in which they will be called when the hook is triggered. This provides the means for multiple modules (or multiple instances of the same module) to be connected to each of the hooks with deterministic ordering. Each module will be called in turn and will return a decision to the netfilter framework after processing that indicates what should be done with the packet.


IPTables Tables and Chains

The iptables firewall uses tables to organize its rules. These tables classify rules according to the type of decisions they are used to make. For instance, if a rule deals with network address translation, it will be put into the nat table. If the rule is used to decide whether to allow the packet to continue to its destination, it would probably be added to the filter table.

Within each iptables table, rules are further organized within separate « chains ». While tables are defined by the general aim of the rules they hold, the built-in chains represent the netfilter hooks which trigger them. Chains basically determine when rules will be evaluated.

As you can see, the names of the built-in chains mirror the names of the netfilter hooks they are associated with:

  • PREROUTING: Triggered by the NF_IP_PRE_ROUTING hook.
  • INPUT: Triggered by the NF_IP_LOCAL_IN hook.
  • FORWARD: Triggered by the NF_IP_FORWARD hook.
  • OUTPUT: Triggered by the NF_IP_LOCAL_OUT hook.
  • POSTROUTING: Triggered by the NF_IP_POST_ROUTING hook.

Chains allow the administrator to control where in a packet’s delivery path a rule will be evaluated. Since each table has multiple chains, a table’s influence can be exerted at multiple points in processing. Because certain types of decisions only make sense at certain points in the network stack, every table will not have a chain registered with each kernel hook.

There are only five netfilter kernel hooks, so chains from multiple tables are registered at each of the hooks. For instance, three tables have PREROUTING chains. When these chains register at the associated NF_IP_PRE_ROUTING hook, they specify a priority that dictates what order each table’s PREROUTING chain is called. Each of the rules inside the highest priority PREROUTING chain is evaluated sequentially before moving onto the next PREROUTING chain. We will take a look at the specific order of each chain in a moment.
Lire la suite…

Change the IPTables log file

21/11/2023 Comments off

An important aspect of any firewall are the log files. Iptables on Linux provides logging functionality, however by default, it will get outputted to the /var/log/messages log file. This can clutter things up, and make it hard to check the logs.

If you want to change the file that IPTables logs to, you need to set up your iptables rules to output a log prefix. Rsyslog will then be configured to pick up this prefix, and output the information to a custom log file, containing just the iptables log information.
Install rsyslog if it is not already installed.

$ sudo apt-get install -y rsyslog

Lire la suite…

Categories: Réseau, Système Tags: , , ,

Voyage au centre du noyau: Traffic Control, la QoS

18/11/2023 Comments off

Gérer la QoS.

On peut aujourd’hui largement envisager d’héberger un ou plusieurs services sur son serveur à domicile, et des mouvements comme auto-hebergement.fr l’on bien illustré. Reste le problème de la bande passante en upload, qui bien que largement suffisante pour héberger des serveurs web, email, jabber ou autre, reste à utiliser intelligemment.

Linux fournit cette intelligence, sous forme d’un scheduler de paquets nommé Traffic Control (TC, pour les intimes), et l’objectif de cet article est de présenter cette technologie et sa mise en place dans un cas d’étude d’hébergement Web, DNS et même BitTorrent. Notons au passage que bon nombre de scripts et programmes existent pour simplifier la mise en place de la QoS (Quality of Service). Citons Wondershaper, Shorewall, ADSL-Optimizer par exemple. Cet article n’en parlera pas, car l’objectif est ici de faire mais aussi de comprendre comment ça marche sous le capot, et pour ça, il faut démonter le moteur et mettre les mains dans le cambouis.

1. Traffic Control, la QoS, les bases

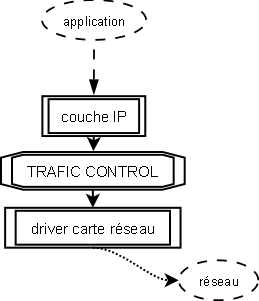
Traffic Control travaille sur les paquets sortant du noyau. Il n’a pas, initialement, pour objectif de contrôler le trafic des paquets entrants. Cette portion de code du noyau se situe entre la couche IP et le pilote du matériel qui transmet sur le réseau. On est donc très bas dans les couches. En réalité, c’est Traffic Control qui est constamment en charge de transmettre au driver de la carte réseau le paquet à envoyer.

figure1-tcgeneral

Cela signifie, en fait, que le module TC – le scheduler de paquet – est en permanence activé dans le noyau, même quand vous ne pensez pas l’utiliser. Par défaut, ce scheduler maintient une queue (prononcer kiou, une file d’attente) similaire à FIFO dans laquelle le premier paquet entré est donc le premier sortit.

La base de TC est la Queuing Discipline (qdisc) qui représente la politique de scheduling appliquée à une queue. Il existe différentes qdisc. Comme pour le scheduling processeur, on retrouve les méthodes FIFO, FIFO à plusieurs files, FIFO avec hash et round robin (SFQ). On a également un système Token Bucket Filter (TBF) qui attribue des jetons (tokens) à une qdisc pour en limiter le débit (pas de token = pas de transmission = on attend d’avoir un jeton disponible). Cette dernière politique a ensuite été étendue à un TBF hiérarchique, le HTB (Hierarchical Token Bucket). Les politiques que nous allons étudier ici sont TBF, qui pose les fondamentaux, SFQ et HTB. Nous allons également jeter un coup d’oeil à la politique par défaut, que, tout Monsieur Jourdain que nous sommes, nous utilisons sans le savoir: pfifo_fast.

1.1 Premier contact

Jean-Kevin est pressé, il n’a pas de temps à perdre, et tout de suite maintenant, il doit limiter la bande passante sortante de son serveur web à 200kbits par secondes (25ko/s). Au diable la théorie, on y reviendra plus tard, mettons tout de suite les mains dans le cambouis. La mécanique que nous allons mettre en place est simple. Nous allons utiliser une règle Netfilter pour marquer les paquets qui nous intéressent. Ensuite, nous allons fournir à TC une politique qui s’appliquera sur les paquets contenant la marque définie. C’est parti.

1.2 Netfilter MARK

Netfilter permet d’interagir directement avec la structure représentant un paquet dans le noyau. Cette structure, le sk_buff, possède un champ « __u32 nfmark » que l’on va renseigner et qui sera lu par le filtre de TC pour sélectionner la classe de destination du paquet. La règle iptables suivante va appliquer la marque ’80’ sur les paquets sortant (chaine OUTPUT) ayant pour port source le port 80:

# iptables -t mangle -A OUTPUT -o eth0 -p tcp --sport 80 -j MARK --set-mark 80

On peut vérifier que cette règle est bien appliquée aux paquets sortants en visualisant les statistiques de Netfilter.

# iptables -L OUTPUT -t mangle -v
Chain OUTPUT (policy ACCEPT 74107 packets, 109M bytes)
 pkts bytes target prot opt in  out  source   destination
73896  109M MARK   tcp  --  any eth0 anywhere anywhere    tcp spt:www MARK xset 0x50/0xffffffff

1.3 Deux classes dans un arbre

Le binaire /sbin/tc est compris dans le package iproute (sous Debian). Un simple aptitude suffit à l’installer, s’il ne l’est pas déjà. Nous allons créer un arbre dont la racine appliquera la politique HTB. Cet arbre va contenir deux classes: une pour notre trafic marqué, l’autre pour tout le reste et qui sera donc considérée par défaut.

# tc qdisc add dev eth0 root handle 1: htb default 20
# tc class add dev eth0 parent 1:0 classid 1:10 htb rate 200kbit ceil 200kbit prio 1 mtu 1500
# tc class add dev eth0 parent 1:0 classid 1:20 htb rate 1024kbit ceil 1024kbit prio 2 mtu 1500

Les deux classes filles sont raccrochés à la racine. Ces classes possèdent un débit garantie (rate) et un débit maximal opportuniste (ceil). Si la bande passante n’est pas utilisée, alors une classe pourra monter son débit jusqu’à la valeur de ceil. Sinon c’est la valeur de rate qui s’applique. Cela veut dire que la somme des valeurs de rate doit correspondre à la bande passante disponible. Dans le cas d’un upload ADSL classique chez un fournisseur correct, cela sera d’environ 1024kbits (dans le meilleur des cas, éloignement du DSLAM, etc…).

Nous avons maintenant d’un côté un arbre de contrôle de trafic, et d’un autre côté du marquage de paquets. Il reste donc à relier les deux. Cela est fait avec les règles de filtrage de TC. Ces règles sont très simples. On dit à TC de prendre en charge (handle) les paquets portant la marque 80 et de les envoyer (fw flowid) à la classe correspondante. Un point important toutefois, un filtre doit être rattaché à la racine « root » de l’arbre. Sinon, il n’est pas pris en compte.

# tc filter add dev eth0 parent 1:0 protocol ip prio 1 handle 80 fw flowid 1:10

Faisons maintenant le test avec NetCat, on ouvre un port en écoute qui renvoi des zéro. C’est basique et parfait pour tester notre politique. On lance donc :

# nc -l -p 80 < /dev/zero

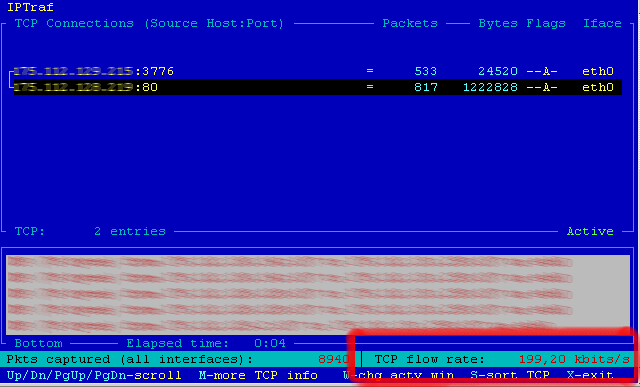
Et sur une autre machine, on lance un telnet vers le port 80 de la machine en écoute. L’outil iptraf permet de visualiser la connexion en cours et, surtout, son débit (voir figure 2).

figure2-debitqos

Comme on le voit dans l’encadré rouge, en bas à droite, le débit de la connexion est de 199,20kbps. On s’approche de beaucoup des 200kbps, la précision dépendant quelques paramètres que nous allons étudier. Si l’on teste une connexion du même type sur un autre port, on verra un débit limité à 1024kbps, ce qui correspond au débit de la classe par défaut qui s’applique à tous les paquets non marqués.

Lire la suite…