La réplication d’un base de données permet de disposer du même jeu de données à tout moment sur deux serveurs ou plus. MySQL permet d’automatiser la recopie des données entre une machine principale et plusieurs secondaires de façon unidirectionnelle (réplication master-slave) ou de façon bidirectionnelle entre 2 serveurs (réplication master-master). Dans ce tutoriel, nous allons mettre en place ces deux types de systèmes, le second étant une extension du premier.
Si vous n’avez pas lu mon article à propos de la création d’une architecture serveurs distribuée, je vous invite à le faire, et spécialement mon exemple de mise en en oeuvre avec 2 serveurs, vous comprendrez peut-être mieux l’utilité d’une configuration de ce type. Pour les plus pressées, sachez simplement que je proposais de créer 2 serveurs web accueillant chacun sa propre base de données, les données étant strictement identiques et chaque insertion ou modification de données étant immédiatement recopiée. Lire la suite…
En 2014 petit budget ne signifie pas nécessairement configuration bas de gamme et il est assez facile de faire tourner de grosses applications ou un grand nombr e de sites internet pour quelques centaines, voire dizaines d’euros. En conséquence directe de la deuxième loi de Moore (qui annonce que la puissance des ordinateurs double tous les 2 ans) et de la guerre que se livrent les société d’hébergement, il est assez facile de se procurer 2 serveurs assez puissants pour bien moins cher qu’un seul serveur de la même puissance il y a 2 ans.
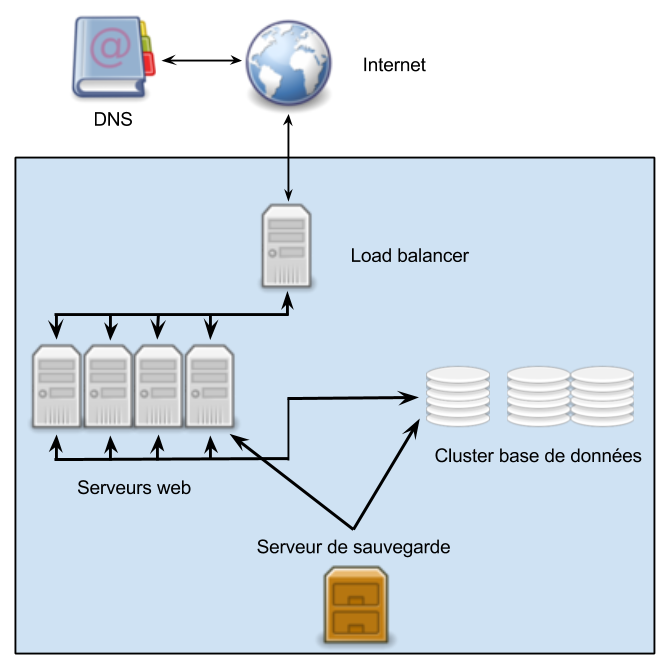
Cela explique que de plus en plus de société se tournent vers des configurations comportant plusieurs serveurs, avec une seule adresse présentée aux internautes. Ces configurations peuvent être plus ou moins complexes et dépendent à la fois des besoins et des ressources à allouer mais globalement ça ressemble à ça :
De quoi se compose notre système ?
Je pense qu’il est nécessaire de détailler les éléments ci-dessus afin de comprendre leur rôle et la façon dont ils interagissent.
Internet : il s’agit du client, l’internaute qui accède au site internet ou à l’application;
DNS : lorsque le client veut accéder à une ressource sur internet, il fait appel à un serveur DNS pour faire la traduction entre le nom de domaine et l’adresse IP du serveur qui fournit la ressource. Ici le serveur DNS semble un peu hors sujet mais j’ai préféré l’inclure parce qu’il va jouer un rôle dans la mise en oeuvre que je vous proposerai par la suite;
Load balancer : bien souvent il s’agit d’un serveur reverse proxy qui se charge de répartir les requêtes entre les différents serveurs de la grappe, parfois il s’agit d’une configuration plus complexe. Pour les montages simples, le load balancing est attribué au serveur DNS, nous y reviendrons par la suite. Ce que vous pouvez constater ici c’est que notre load balancer est le seul serveur visible depuis le monde extérieur.
Serveurs web : nous avons ici une grappe de n serveurs (en fonction de la puissance demandée) dont le rôle est de traiter les requêtes et de renvoyer les ressources demandées. Les fichiers disponibles sur toutes ces machines sont strictement identiques. Bien souvent il s’agit même d’un cluster dans lequel tous les nœuds agissent comme une seule et même entité, parfois il s’agit de machines indépendantes qui ont un système de fichiers distribué tel que Glusterfs;
Cluster base de données : les principaux systèmes de gestion de base de données sont capables de fonctionner en cluster, même sur des environnements hétérogènes. Pour cette raison, quelque soit le nombre de serveurs sur lesquels les bases de données sont réparties, j’ai choisi de les faire apparaître comme un cluster et non comme des serveurs distincts;
Serveur de sauvegarde : il n’est peut-être pas nécessaire de s’étendre. Quel que soit le dispositif, il dispose d’une grande capacité de stockage et d’un accès à sens unique à l’un des serveurs applicatifs (s’ils ont tous les mêmes fichiers, inutile d’ouvrir une porte sur tous) et au cluster de base de données.
POSIX Access Control Lists (ACLs) are more fine-grained access rights for files and directories. An ACL consists of entries specifying access permissions on an associated object. ACLs can be configured per user, per group or via the effective rights mask.
These permissions apply to an individual user or a group, and use the same as rwxfound in regular permissions.
Before beginning to work with ACLs the file system must be mounted with ACLs turned on. This can be done in /etc/fstab for the changes to be permanent.
Résumons un peu la situation Nous avons maintenant accès à http:// IPSERVEUR:32400/web/ et nous pouvons nous connecter mais le serveur ne dis que nous n’avons pas les permissions !
Remarque : Pour se connecter , il faut un compte Plex (aller sur plex.tv et inscrivez vous c’est gratuit)
2e Partie :
Pour pouvoir activer Plexmediaserver, nous devons nous connecter à l’URL (http:// IPSERVEUR:32400/web/) local comme si nous étions le serveur. Et pour ça , rien de plus facile , nous allons créer un tunnel SSH.
ssh -L 32400:127.0.0.1:32400 root@IPSERVEUR
De là, aller sur votre navigateur web (chrome, firefox,…) à l’adresse suivante :
127.0.0.1:32400/web/
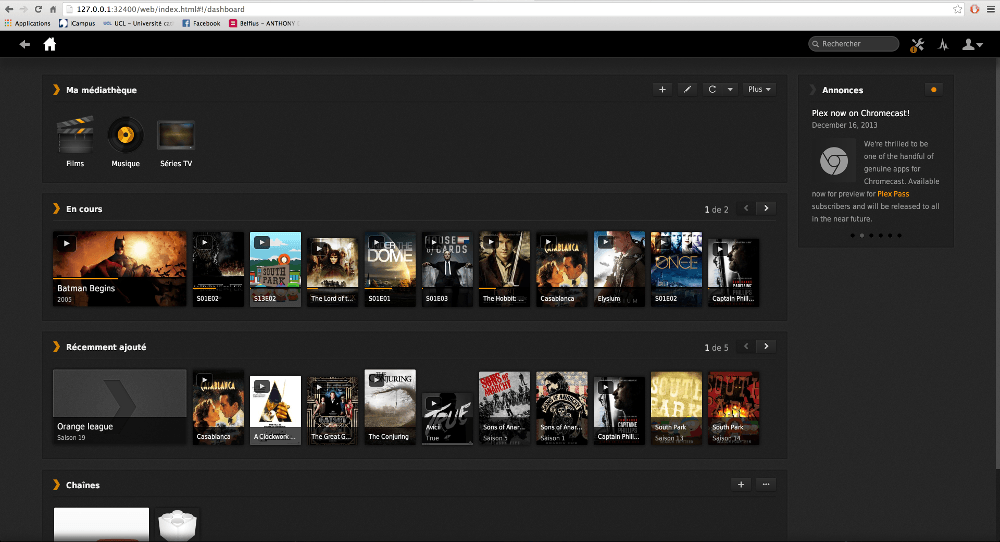
Vous accéderez en local et pourrez activer Plexmediaserver.
Une fois installé , vous arrêtons le Tunnel SSH avec cette ligne code suivante :